gitlab ci cd 不完全指南
gitlab 可能大家很常用,CI、CD 也应该早有耳闻,但是可能还没有去真正地了解过,这篇文章就是我对 gitlab CI、CD 的一些理解,以及踩过的一些坑,希望能帮助到大家。
什么是 CI、CD
CI(Continuous Integration)持续集成,CD(Continuous Deployment)持续部署(也包含了持续交付的意思)。
CI 指的是一种开发过程的的自动化流程,在我们提交代码的时候,一般会做以下操作:
lint检查,检查代码是否符合规范- 自动运行测试,检查代码是否能通过测试
这个过程我们可以称之为 CI,也就是持续集成,这个过程是自动化的,也就是说我们不需要手动去执行这些操作,只需要提交代码,这些操作就会自动执行。
CD 指的是在我们 CI 流程通过之后,将代码自动发布到服务器的过程,这个过程也是自动化的。 在有了前面 CI 的一些操作之后,说明我们的代码是可以安全发布到服务器的,所以就可以进行发布的操作。
为什么要使用 CI、CD
实际上,就算没有 CI、CD 的这些花里胡哨的概念,对于一些重复的操作,我们也会尽量想办法会让它们可以自动化实现的,只不过可能效率上没有这么高,但是也是可以的。
CI、CD 相比其他方式的优势在于:
- 一次配置,多次使用:我们需要做的所有操作都通过配置固定下来了,每次提交代码我们都可以执行相同的操作。
- 可观测性:我们可以通过 CI、CD 的日志来查看每次操作的执行情况,而且每一次的 CI、CD 执行的日志都会保留下来,这样我们就可以很方便地查看每一次操作的执行情况。
- 自动化:我们不需要手动去执行 CI、CD 的操作,只需要提交代码,CI、CD 就会自动执行。
- 少量配置:一般的代码托管平台都会提供 CI、CD 的功能,我们只需要简单的配置一下就可以使用了。同时其实不同平台的 CI、CD 配置也是有很多相似之处的,所以我们只需要学习一种配置方式,就可以在不同平台上使用了。
gitlab CI、CD
在开始之前,我们可以通过下图来了解一下 CI、CD 的整体流程:
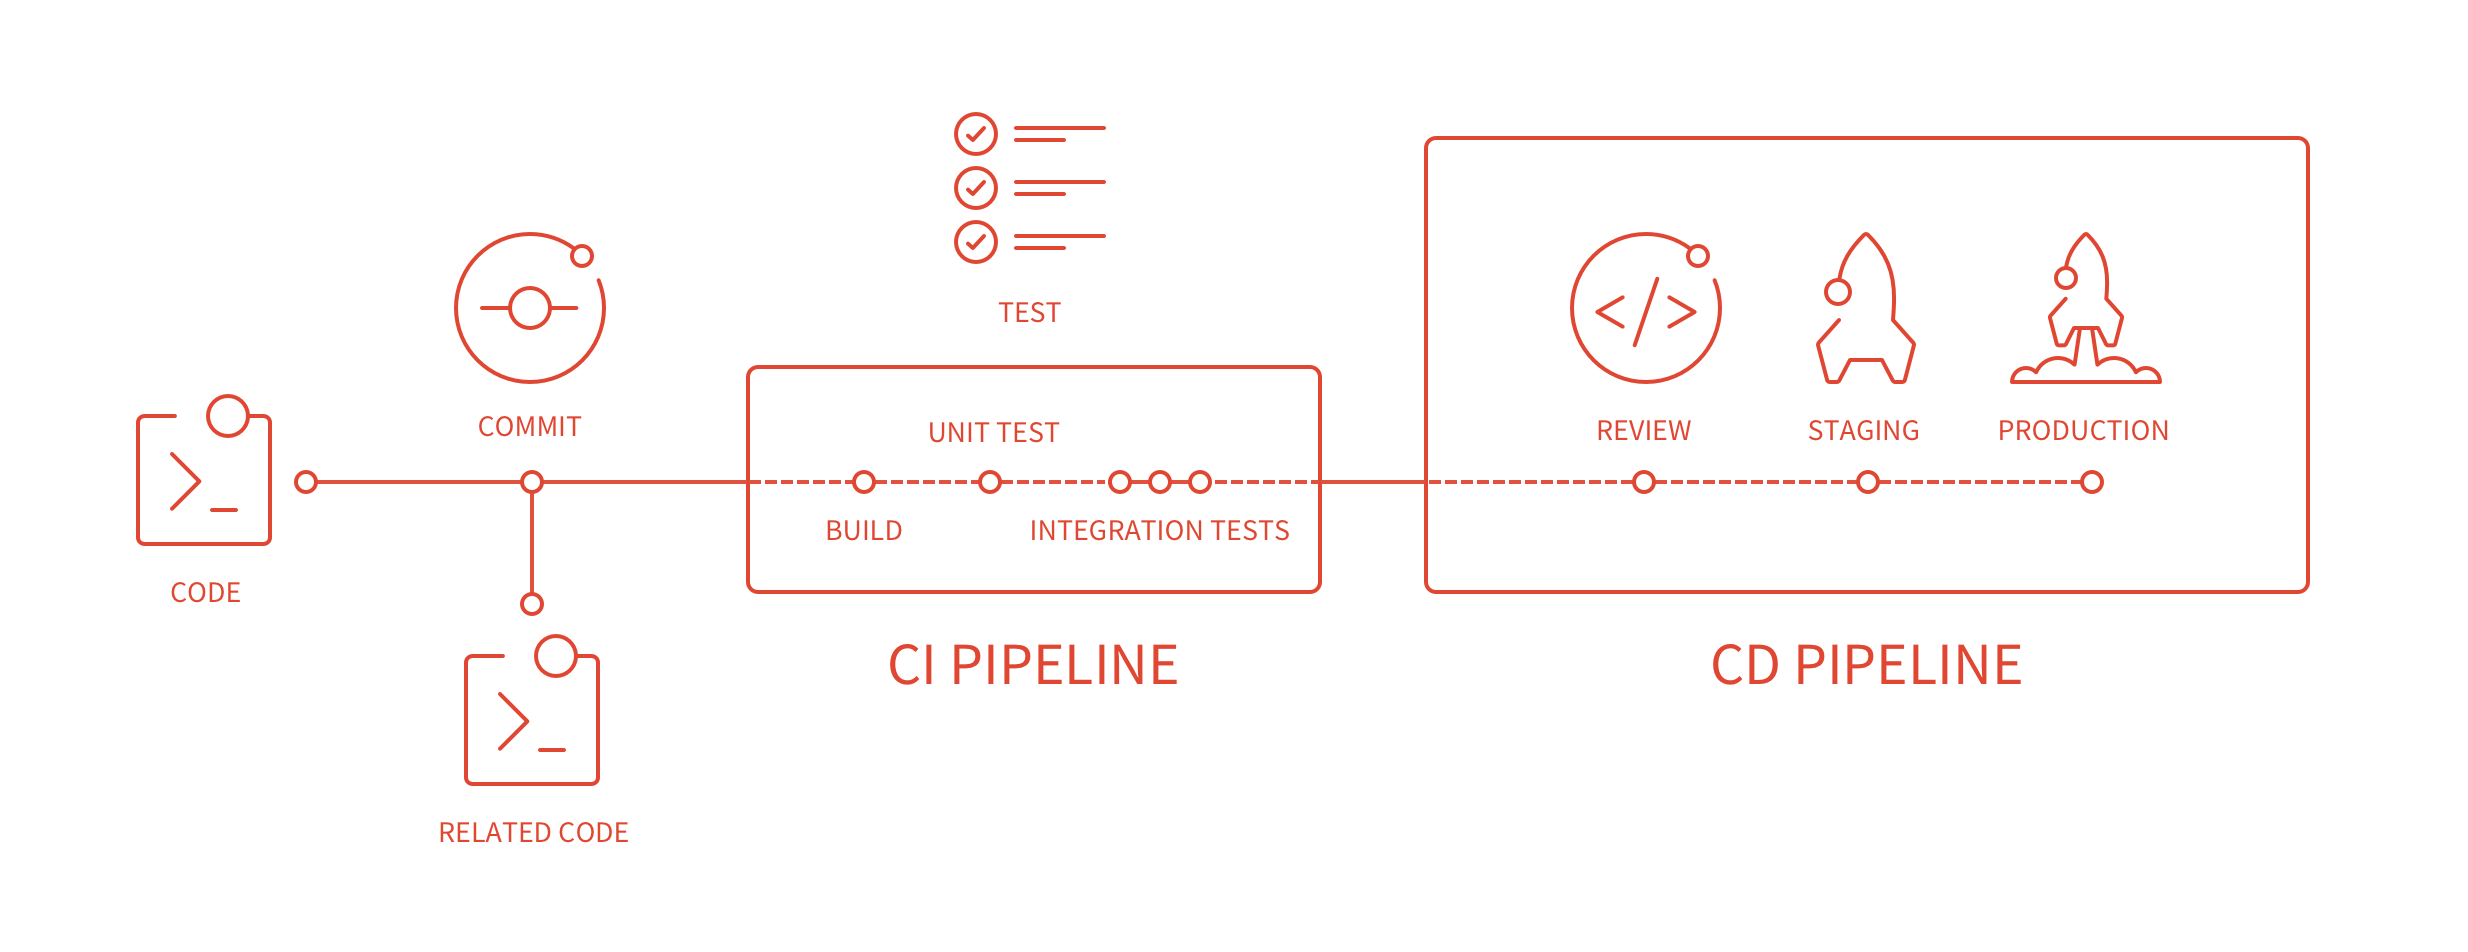
- 在开发人员提交代码之后,会触发 gitlab 的 CI 流水线。也就是上图的
CI PIPELINE,也就是中间的部分。 - 在 CI 流水线中,我们可以配置多个任务。比如上图的
build、unit test、integration tests等,也就是构建、单元测试、集成测试等。 - 在 CI 流水线都通过之后,会触发 CD 流水线。也就是上图的
CD PIPELINE,也就是右边的部分。 - 在 CD 流水线中,我们可以配置多个任务。比如上图的
staging、production等,也就是部署到测试环境、部署到生产环境等。
在 CD 流程结束之后,我们就可以在服务器上看到我们的代码了。
gitlab CI、CD 中的一些基本概念
在开始之前,我们先来了解一下 gitlab CI、CD 中的一些基本概念:
pipeline:流水线,也就是 CI、CD 的整个流程,包含了多个stage,每个stage又包含了多个job。stage: 一个阶段,一个阶段中可以包含多个任务(job),这些任务会并行执行,但是下一个stage的job只有在上一个stage的job执行通过之后才会执行。job:一个任务,这是 CI、CD 中最基本的概念,也是最小的执行单元。一个stage中可以包含多个job,同时这些job会并行执行。runner:执行器,也就是执行job的机器,runner跟 gitlab 是分离的,runner需要我们自己去安装,然后注册到 gitlab 上(不需要跟 gitlab 在同一个服务器上,这样有个好处就是可以很方便实现多个机器来同时处理 gitlab 的 CI、CD 的任务)。tag:runner和job都需要指定标签,job可以指定一个或多个标签(必须指定,否则job不会被执行),这样job就只会在指定标签的runner上执行。cache: 缓存,可以缓存一些文件,这样下次流水线执行的时候就不需要重新下载了,可以提高执行效率。artifacts: 这代表这构建过程中所产生的一些文件,比如打包好的文件,这些文件可以在下一个stage中使用,也可以在pipeline执行结束之后下载下来。variables:变量,可以在pipeline中定义一些变量,这些变量可以在pipeline的所有stage和job中使用。services:服务,可以在pipeline中启动一些服务,比如mysql、redis等,这样我们就可以在pipeline中使用这些服务了(常常用在测试的时候模拟一个服务)。script: 脚本,可以在job中定义一些脚本,这些脚本会在job执行的时候执行。
CI、CD 的工作模型
我们以下面的配置为例子,简单说明一下
pipeline、stage、job
的工作模型,以及 cache 和 artifacts
的作用:
ci 配置文件(也就是一个 pipeline
的所有任务):
1 | # 定义一个 pipeline 的所有阶段,一个 pipeline 可以包含多个 stage,每个 stage 又包含多个 job。 |
上面的配置文件的 pipeline
执行过程可以用下面的图来表示:
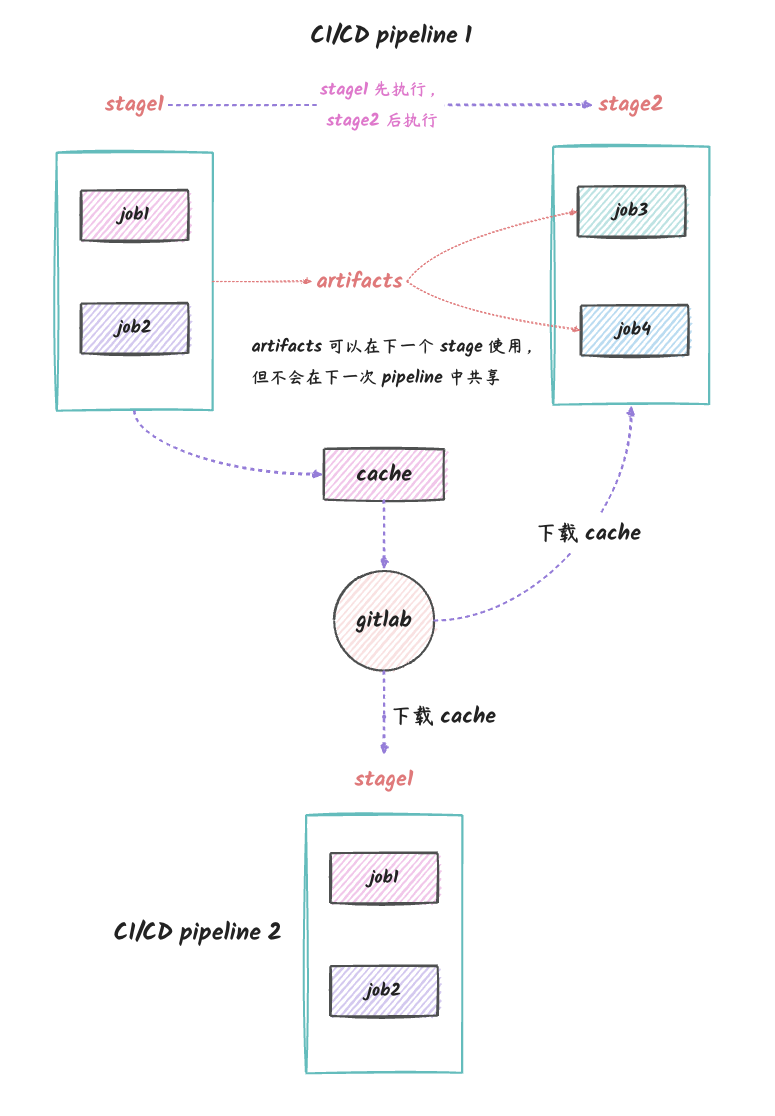
说明:
- 上面的图有两个
pipeline被执行了,但是pipeline2没有全部画出来 - 其中,在
pipeline 1中,stage1中的job会先被执行,然后才会执行stage2中的job。 stage1中的job1和job2是可以并行执行的,这也就是stage的本质上的含义,表示了一个阶段中不同的任务,比如我们做测试的时候,可以同时对不同模块做测试。job1和job2都指定了tag1标签,所以job1和job2只会在标签为tag1的runner上执行。job1中,我们创建了一个test.txt文件,这个文件会作为stage1的构建产物,它可以在stage2中被使用,也就是job3和job4都可以读取到这个文件。一种实际的场景是,前端部署的时候,build 之后会生成可以部署的静态文件,这些静态文件就会被保留到部署相关的 stage 中。需要注意的是,artifacts只会在当前pipeline后续的stage中共享,不会在pipeline之间共享。- 同时,在
job1中,我们也指定了cache,这个cache会在job1执行结束之后保存起来,不同于artifacts,cache是可以在不同的pipeline之间共享的。一种很常见的使用场景就是我们代码的依赖,比如node_modules文件夹,它可以加快后续pipeline的执行流程,因为避免了重复的依赖安装。
需要特别注意的是:
cache是跨流水线共享的,而artifacts只会在当前流水线的后续 stage 共享。
gitlab runner 和 executor
gitlab runner 在 CI/CD
中是一个非常重要的东西,因为我们写的 CI/CD 的配置就是在
runner 上运行的,如果我们想要执行 CI/CD
任务,我们必须先安装配置 gitlab-runner。
其中 runner 是一台执行 CI/CD 脚本的机器(也就是安装了
gitlab-runner 的机器)。这个机器可以部署在 gitlab
服务器以外的任意一台电脑上,当然也可以跟 gitlab 在同一台服务器。
而每一个 runner 会对应一种特定的
executor,executor 就是我们执行 CI/CD 里面
script 的环境。比如如果我们指定了 executor
类型为 docker,那么我们 CI/CD 脚本里面的
script 将会在一个独立的 docker 容器中执行。
简单来说,runner 是执行 CI/CD
脚本的机器,这个机器上有不同类型的 executor,一个
executor 代表着一个不同类型的命令行终端,最常见的是
shell、docker,当然也支持 widnows 的
powershell。
我们可以通过下图来了解一下 gitlab 是怎么跟 runner
配合的:
gitlab 是通过
tags来找到运行脚本的runner的,如果job的tags跟runner的tags匹配了,就可以将那个job放到runner上处理。
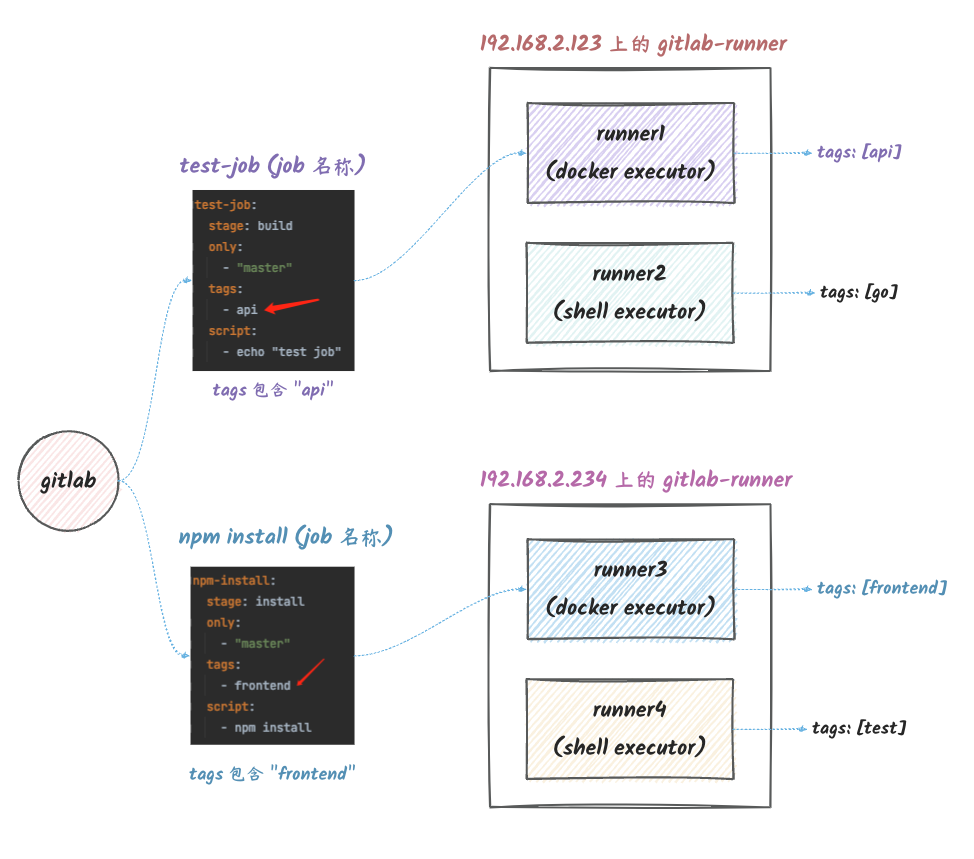
说明:
- 我们在两台机器上安装了
gitlab-runner,它们的 IP 是192.168.2.123和192.168.2.234。 test-job的tags中包含了api这个tag,而runner1的tags也包含了api这个tag,因此test-job会被runner1执行。- 同理,
npm-install这个job会被runner3处理。
从上图我们可以看到,其实不同的
runner是有可能位于不同的机器上的。
其他一些在个人实践中的一些经验
gitlab 的 CI、CD 是一个很庞大的话题,同时很多内容可能比较少用,所以本文只是介绍个人在实践中用到的一些内容,其他的东西如果有需要,可以自行查阅官方文档。
指定特定分支才会执行的 job
这个算是基本操作了,我们可以通过 only
来指定特定分支才会执行的 job,也有其他方法可以实现,比如
rules,具体请参考官方文档。
1 | deploy-job: |
不同 job 之间的依赖
这个也是基本操作,我们可以通过 needs 来指定不同
job 之间的依赖关系,比如 job1 依赖
job2,那么 job1 就会在 job2
执行完毕之后才会执行。
1 | job1: |
指定执行 job 的 runner
我们可以通过 tags 来指定 job 执行的
runner,比如我们可以指定 job 只能在
api 标签的 runner 上执行。
1 | build-job: |
如果我们没有标签为
api的runner,那么这个job就会一直不会被执行,所以需要确保我们配置的tag有对应的runner。
指定 job 的 docker image
注意:这个只在我们的
runner的executor为docker的时候才会生效。也就是我们的runner是一个docker容器。
有时候,我们需要执行一些特定命令,但是我们全局的 docker
镜像里面没有,可能只需要一个特定的 docker
镜像,这个时候我们可以通过 image 来指定 job 的
docker 镜像。
1 | deploy-job: |
为我们的集成测试指定一个 service
在我们的 CI
流程中,可能会有一些集成测试需要使用到一些服务,比如我们的
mysql,这个时候我们可以通过 services
来指定我们需要的服务。
1 | test_rabbitmq: |
复用 yaml 配置片段
在 yaml 中,有一种机制可以让我们复用 yaml
配置片段,比如:
1 | # 发布代码的 job |
上面的代码中,我们定义了一个 release-job
的配置片段,然后在 deploy-release 和
deploy-master
中,我们都引用了这个配置片段,这样我们就可以复用这个配置片段了。
等同于下面的代码:
1 | # 发布代码的 job |
在
yaml的术语中,这一种机制叫做anchor。
cache vs artifacts
初次使用的人,可能会对这个东西有点迷惑,因为它们好像都是缓存,但是实际上,它们的用途是不一样的。
cache是用来缓存依赖的,比如node_modules文件夹,它可以加快后续pipeline的执行流程,因为避免了重复的依赖安装。artifacts是用来缓存构建产物的,比如build之后生成的静态文件,它可以在后续的stage中使用。表示的是单个 pipeline 中的不同 stage 之间的共享。
指定 artifacts 的过期时间
我们可以通过 expire_in 来指定 artifacts
的过期时间,比如:
1 | job1: |
因为我们的 artifacts
有时候只是生成一些需要部署到服务器的东西,然后在下一个
stage 使用,所以是不需要长期保留的。所以我们可以通过
expire_in 来指定一个比较短的 artifacts
的过期时间。
cache 只 pull 不 push
gitlab CI 的 cache 有一个 policy
属性,它的值默认是 pull-push,也就是在 job
开始执行的时候会拉取缓存,在 job
执行结束的时候会将缓存指定文件夹的内容上传到 gitlab 中。
但是在实际使用中,我们其实只需要在安装依赖的时候上传这些缓存,其他时候都只是读取缓存的。所以我们在安装依赖的
job 中使用默认的 policy,而在后续的 job
中,我们可以通过 policy: pull
来指定只拉取缓存,不上传缓存。
1 | job: |
cache 的 key 使用文件
这一个特性是非常有用的,在现代软件工程的实践中,往往通过
*.lock
文件来记录我们使用的额依赖的具体版本,以保证在不同环境中使用的时候保持一致的行为。
所以,相应的,我们的缓存也可以在 *.lock
这类文件发生变化的时候,重新生成缓存。上面的例子就使用了这种机制。
script 中使用多行命令
在 script 中,我们可以使用多行命令,比如:
1 | job: |
CD - 如何同步代码到服务器
如果我们的项目需要部署到服务器上,那么我们还需要做一些额外的操作,比如同步代码到服务器上。 如果我们的 gitlab 是通过容器执行的(也就是说 gitlab 是通过 docker 启动的),或者我们的 runner 的 executor 是 docker,那么有一种比较常见的方法是通过 ssh 私钥来进行部署。
我们可以通过以下流程来实现:
- 新建一对 ssh key,比如
id_rsa和id_rsa.pub。 - 将
id_rsa.pub的内容添加到服务器的authorized_keys文件中。 - 将
id_rsa上传到 gitlab 中(在项目的 CI/CD 配置中,配置一个变量,变量名为PRIVATE_KEY,内容为id_rsa的内容,类型为file)。 - 在我们的
ci配置文件中,添加如下配置即可:
1 | before_script: |
这里的 rsync 命令中,我们使用了
-o StrictHostKeyChecking=no
参数,这是为了避免每次都需要手动输入 yes
来确认服务器的指纹。
安全最佳实践:
- 为每一个 project 配置 ssh key 变量,如果是全局变量的话,其他 project 可以在未授权的情况下,访问到这个私钥,这是非常危险的。
- 使用单独的仓库来保存 ci 配置文件,防止其他人未经授权就修改 ci 配置文件,这也是非常危险的。
必须严格遵循以上两步,否则会造成严重的安全问题。因为拿到了私钥,就等于拿到了我们的服务器密码。
ERROR: Job failed: exit code xx 解决方案
我们在使用的时候可能会经常遇到这种错误(在 job
执行的输出里面),如果运气好,在输出里面也有一些额外的错误信息,
这种是最好处理的,它已经告诉你错误原因了。还有一种非常坑爹的情况是:job
失败了,只有一个非 0
的退出状态码,但是没有任何的报错信息,这种情况就比较难处理(更加坑爹的是,偶尔出现这种失败)。
job script 的执行流程
如果我们理解了 gitab CI/CD 中 job
的执行原理,那么这个问题其实就很好解决了,job 的
script 执行流程如下:
- 拿到
script中第一条命令,然后执行。 - 检查上一步的退出状态码,如果状态码为
0,继续执行下一条命令。否则,
job直接失败,然后显示信息ERROR: Job failed: exit code <xx>,最后的<xx>就是上一条命令的非 0 的那个退出状态码。 - 按以上两个步骤来一条条执行
script中的命令。
如果使用的是 bash shell,我们可以通过 echo $? 来获取上一条命令的退出状态码。状态码方面的约定都是:0 表示成功,非 0 表示不成功。
解决方法
知道了 job
的执行原理之后,问题就很好解决了,我们只需要在 job
执行日志中找到最后那一条命令即可:
- 先看这个命令是否有执行失败相关的错误输出信息,如果有,那么解决对应错误即可。
- 如果这个执行失败的命令,一点输出都没有。那么我们可以深入了解一下这个命令的退出状态码什么时候等于我们
job的状态码,然后再对症下药。
一个实例
下面是一个 job
日志的最后几行,但是不包含具体的错误信息:
1 | if (( $need_restart_queue == 1 )); then ssh $user@$host "supervisorctl restart xx"; fi |
第一行是执行的命令,这个命令中,通过 ssh
执行了一条远程命令,然后退出。第二行是 job
失败后做清理操作输出的日志,最后一行输出 job
失败的错误码。
就是这个错误,困扰了我几天,因为它是偶尔失败的。
在这个例子中,比上面说到的要复杂一点,这里通过了 ssh
来执行远程命令,如果通过 ssh 执行远程命令,那么
ssh
命令的退出状态码就是执行的那个远程命令的退出状态码。
明确了这一点,我们就可以把问题定位在那个远程命令
supervisorctl restart xx
上,也就是说我们的失败是因为这个命令导致的。
后面排查发现,supervisorctl
命令本身就有一定几率失败,针对这种情况,有两种解决方案:
- 重试,可以给
job指定重试次数,可以是 0~2,也就是说 gitlab 的job最多可以重试 2 次。 - 忽略这个错误,使用其他解决方案。(我们可以在
ssh命令后面加上|| true来忽略,加上这个,命令退出状态码一定是 0 了)
我是采取了后面那一种解决方法,因为服务器上还有一个定时任务来检测对应的进程,如果进程不存在,则会使用
supervisorctl start xx来启动对应的服务。
总结
最后,总结一下本文中一些比较关键的内容:
- gitlab 中的一些基本概念:
pipeline:代表了一次 CI 的执行过程,它包含了多个stage。stage:代表了一组job的集合,stage会按照顺序执行。job:代表了一个具体的任务,比如build、test、deploy等。
- 一个
stage中的多个job是可以并行执行的。但是下一个stage的job必须要等到上一个stage的所有job都执行完毕之后才会执行。 cache和artifacts的区别:cache是用来缓存依赖的,比如node_modules文件夹,它可以加快后续pipeline的执行流程,因为避免了重复的依赖安装。artifacts是用来缓存构建产物的,比如build之后生成的静态文件,它可以在后续的stage中使用。表示的是单个 pipeline 中的不同 stage 之间的共享。
cache在安装依赖的job中才需要使用默认的policy,也就是pull-push,在其他不需要安装依赖的job中使用pull就可以了,不需要上传缓存。cache的key可以指定多个文件,这样在指定的文件变动的时候,缓存会失效,这往往用在依赖相关的文件中。- 可以使用
services关键字来指定需要启动的服务,比如mysql、redis等,在 job 中可以连接到这些 services,从而方便进行测试。 - 可以使用
yaml的anchor机制来复用一些配置片段,可以少写很多重复的配置。 - 一个
job必须运行在某个runner上,job和runner的关联是通过tag来指定的。